Ich entwickle agentenbasierte KI für Finanz- und Versicherungsdokumente.
Mein Schwerpunkt: belegbare Antworten, verlässliche Evaluation und prüfbare Ergebnisse.
Stuttgart, Deutschland
01
Ausgewählte Projekte
Berufliche KI-Systeme, öffentliche Software und Forschung zeigen unterschiedliche Seiten meiner Arbeit.
2026 · Öffentliche Anwendung
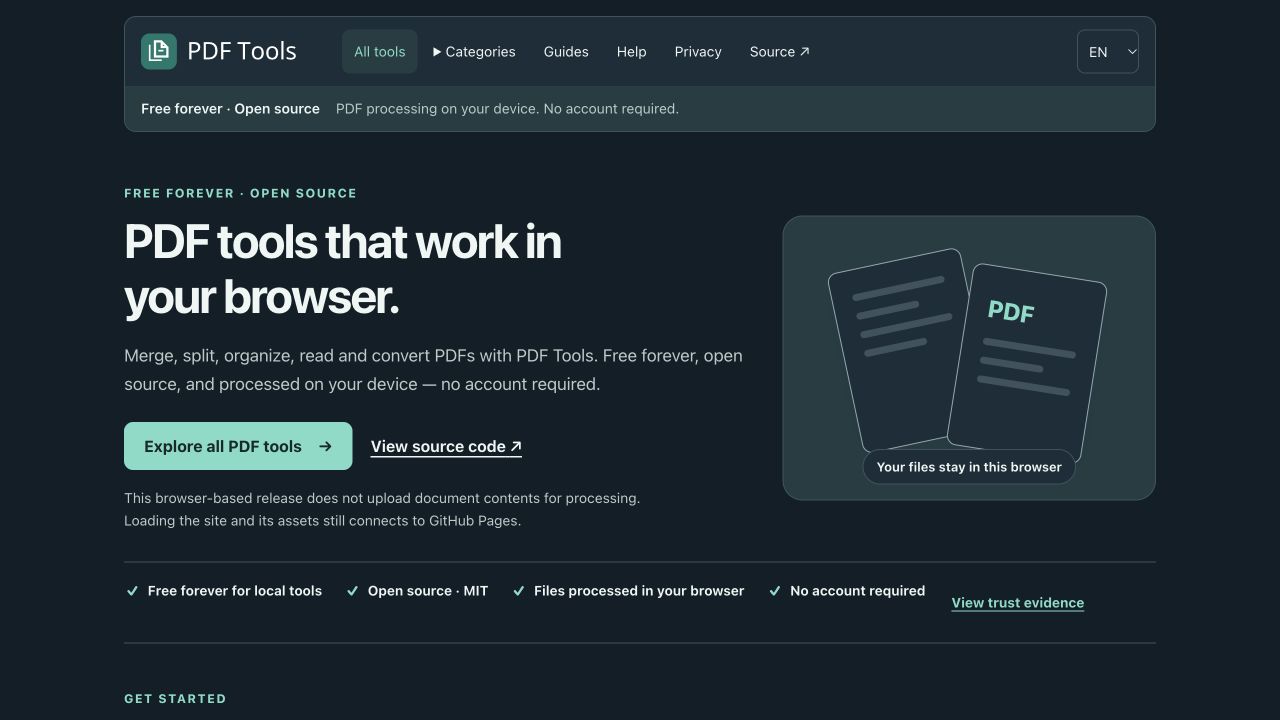
PDF Tools
Vierzehn browserbasierte Werkzeuge zum Zusammenführen, Aufteilen, Organisieren, Lesen und Konvertieren von PDFs. Ausgewählte Dokumente werden auf dem Gerät verarbeitet; zum Laden der Anwendung wird weiterhin GitHub Pages kontaktiert. Zur Entwicklungsarbeit gehören unabhängige Prüfungen heruntergeladener Dateien und klare Grenzen für Dokumentfunktionen, die beim Export verloren gehen können.
Finanz- und Versicherungsdokumente sind lang, uneinheitlich und Fehler können teuer werden. Ich entwickle Pipelines, die sie mit OCR, Retrieval, spezialisierten Agenten und Validierung verarbeiten und strukturierte Ergebnisse liefern, die Menschen prüfen können. Die schwierigen Fragen betreffen oft nicht das Modell selbst, sondern die Belege und den richtigen Zeitpunkt für eine Übergabe an Menschen.
Phishing-Domains können wie vertrauenswürdige Websites aussehen: Bei paypa1.com ersetzt etwa eine Ziffer das L. GlyphNet rendert Domainnamen als Bilder und erkennt solche visuellen Täuschungen mit einem aufmerksamkeitsbasierten CNN. Das Paper berichtet eine AUC von 0,93 auf 4 Mio. Bildern; die separat gerenderte öffentliche Version umfasst 1,29 Mio. Domainpaare.
Eine offene Frage: Können Diffusionsmodelle Sprecher-Embeddings erzeugen, die eine Stimme anonymisieren, ohne ihre Qualität zu zerstören? SpeakerDiff ist ein Prototyp dafür, keine abschließende Antwort. Der Datenschutz muss im vollständigen Konvertierungssystem evaluiert werden; Code und Experimente sind öffentlich.